Exemple de rapport
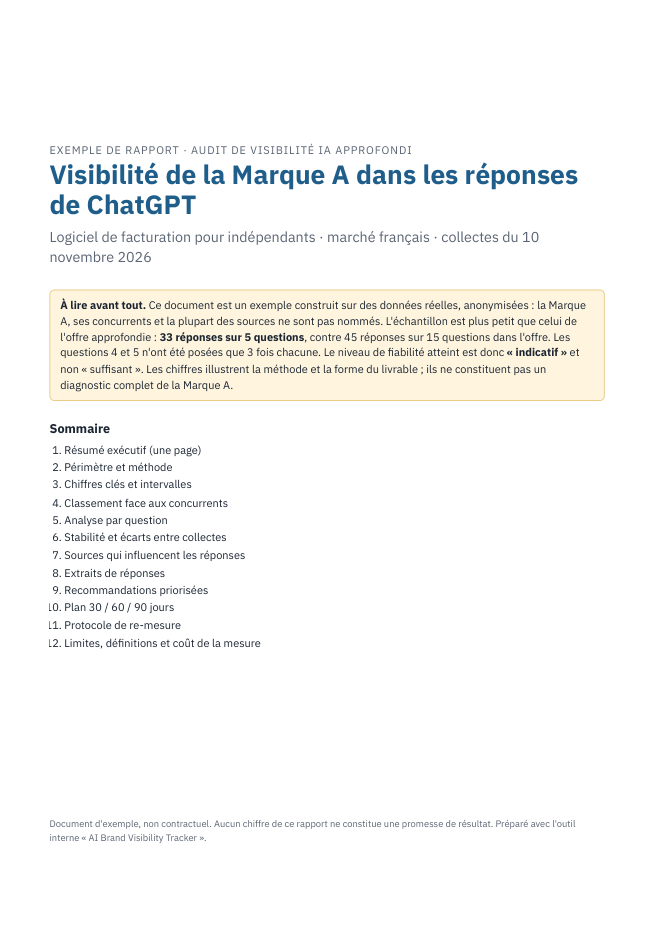
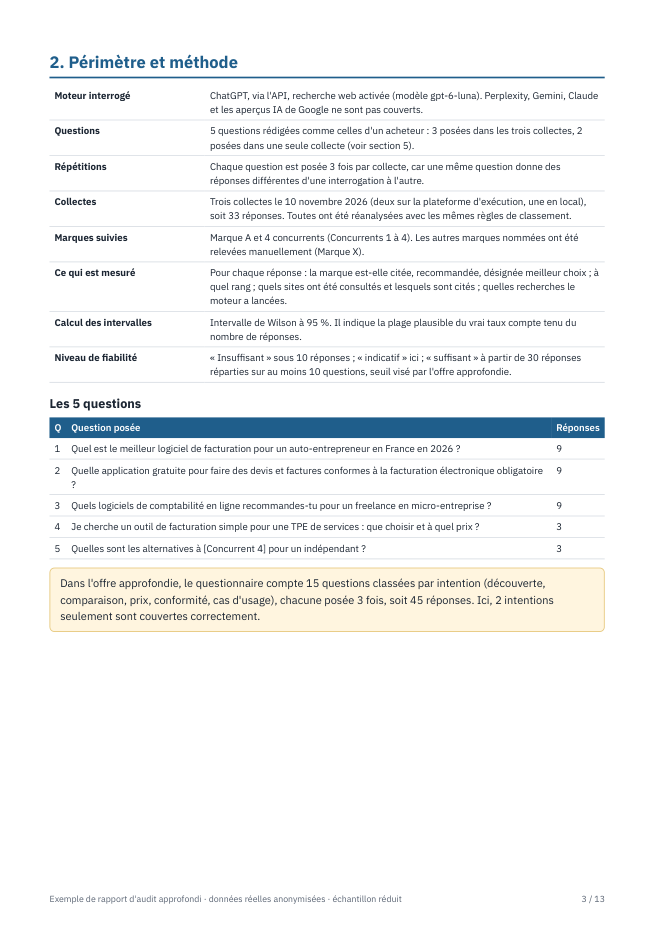
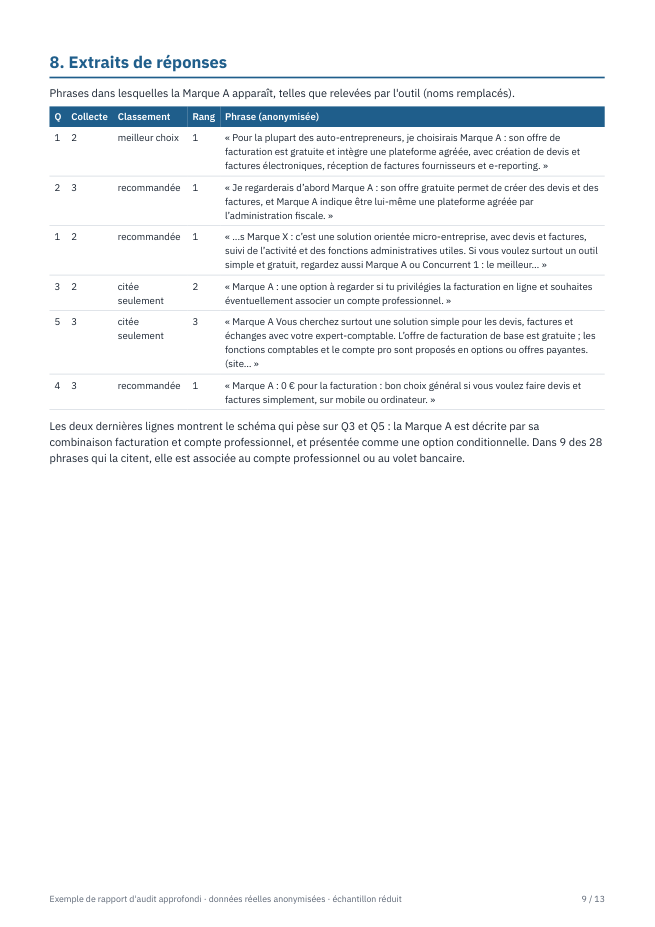
Un vrai rapport, construit sur des mesures réelles faites le 10 novembre 2026, avec toutes les marques anonymisées (Marque A, Concurrent 1 à 4). L'échantillon est plus petit que celui de l'audit approfondi : 33 réponses sur 5 questions, contre 45 réponses sur 15 questions dans l'offre. Il illustre la méthode et la forme du livrable, pas un diagnostic complet.
Aperçu
Un extrait des chiffres de l'exemple
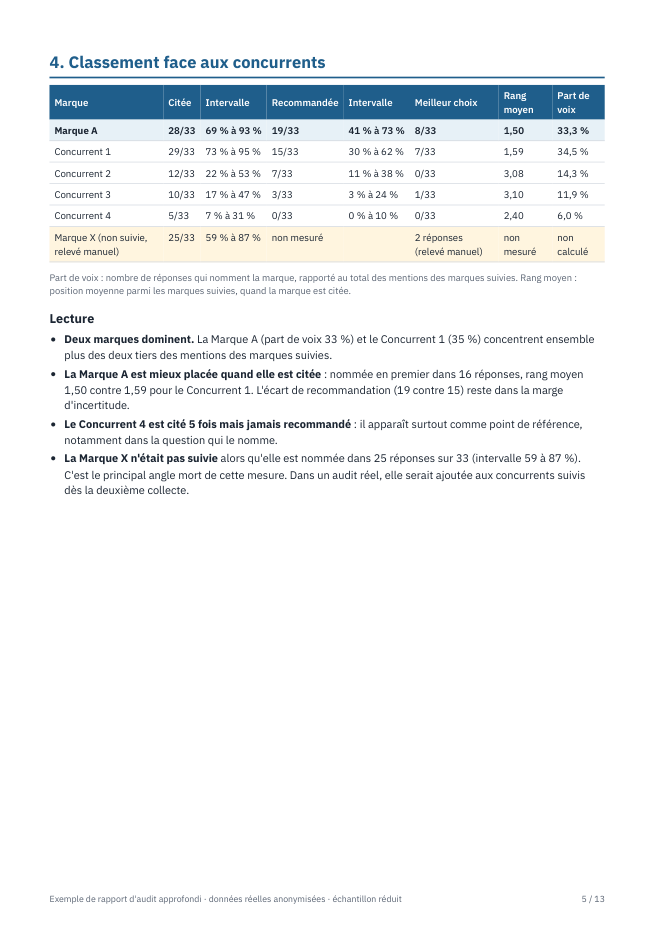
| Indicateur (33 réponses) | Réponses | Taux | Intervalle à 95 % |
|---|---|---|---|
| Marque A citée | 28 / 33 | 85 % | 69 % à 93 % |
| Marque A recommandée (recommandée ou meilleur choix) | 19 / 33 | 58 % | 41 % à 73 % |
| Meilleur choix unique de la réponse | 8 / 33 | 24 % | 13 % à 41 % |
Source : rapport d'exemple téléchargeable ci-dessus. Deux marques dont les intervalles se recouvrent ne peuvent pas être départagées : c'est la raison d'être de l'intervalle. Ces chiffres concernent un exemple anonymisé, pas votre marque.
Lecture prudente. Le rapport lui-même précise que son niveau de fiabilité est « indicatif » et qu'aucun effet sur les réponses de ChatGPT ne peut être garanti : seul un protocole de re-mesure permet de constater une évolution.